如何评估人工智能素养?从学生到员工
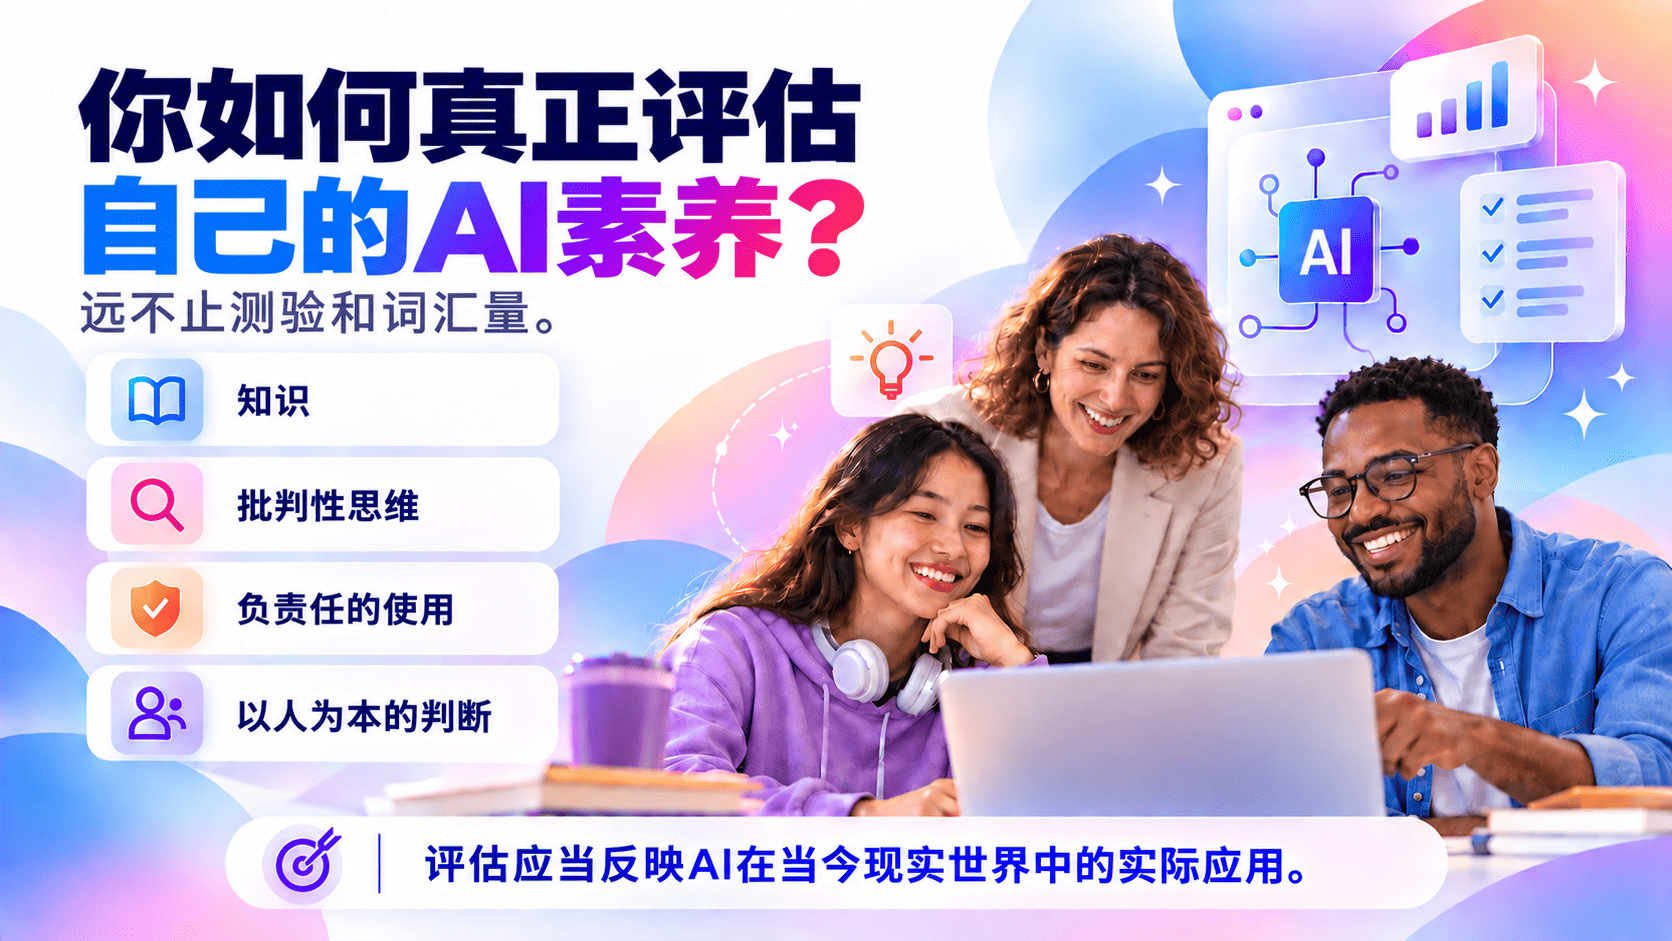
评估人工智能素养,就是衡量我们提出质疑、核实信息、做出判断,并始终将人置于选择核心的能力。
如何评估人工智能素养?从学生到员工
随着人工智能日益融入日常学习和工作,组织面临一个新的问题:究竟该如何评估人工智能素养?
测试一个人能否定义机器学习、解释什么是 AI 幻觉,或识别聊天机器人,相对容易。更难的是判断学生或员工能否识别不可靠的 AI 回答、发现偏见、核实证据、质疑自动化建议,或理解何时必须由人类作出决定。
因此,人工智能素养评估不能仅依赖传统测验。人工智能素养涵盖知识、实际应用、批判性评估、负责任的使用、人类判断以及问题解决能力。评估模型需要体现这种复杂性。
对于学校而言,这意味着不能只测试 AI 词汇。
对于企业而言,这意味着不能只询问员工是否完成了 AI 意识培训课程。
在这两种情况下,真正的问题都是:人们能否在现实情境中以批判性且负责任的方式使用 AI。
从了解 AI 到借助 AI 作出决策
传统评估可能会问:
- 什么是生成式 AI?
- 什么是偏见?
- 什么是 AI 幻觉?
- 什么是机器学习?
这些问题仍然重要,因为基础知识很重要。但知道一个定义并不能证明具备相应能力。
知道“幻觉”的含义,并不能证明一个人能够在 AI 生成的报告中识别出幻觉。
知道 AI 可能存在偏见,并不意味着员工能够发现招聘建议中的偏见,也不意味着学生能够识别 AI 生成的历史解释中的偏见。
知道如何编写提示词,也不一定意味着一个人理解上下文、提供给 AI 的信息质量或模型选择会如何影响其回答,以及该回答是否值得信任。
更有力的能力进阶路径是:
我知道 AI 是什么 → 我会使用它 → 我会质疑它 → 我会评估它 → 我会用它进行创作 → 我能就其使用作出负责任的决定。
这一进阶路径同样适用于教育和职场。
人工智能素养是一种多维能力
有意义的评估应考察多个维度。
1. 知识
学习者是否理解数据、算法、生成式 AI、机器学习、偏见、幻觉和隐私等概念?
2. 实际应用
他们能否针对合适的任务有效使用 AI?
3. 批判性评估
他们能否质疑答案、比较输出、核实主张、识别不确定性并发现缺失的证据?
4. 负责任的使用
他们是否理解保密性、隐私、知识产权、学术或职业诚信、公平性以及安全使用?
5. 人类判断
他们能否识别 AI 何时可以辅助决策,以及何时必须由人类承担责任?
6. 创造与问题解决
他们能否在理解 AI 局限性的同时,使用 AI 解决有意义的问题?
因此,人工智能素养更接近一种能力模型,而不是传统学科考试。
这也使人工智能素养的重要性远远超出学校范围。
同样的能力对于人力资源团队、管理者、客服人员、工程师、营销人员、医疗卫生工作者,以及任何在工作中使用 AI 生成信息的人来说,都越来越重要。
不同情境需要不同的评估
原则相同,但情境应与学习者的实际情况相匹配。
可以要求学生比较两段由 AI 生成的解释,并指出哪些主张需要核实。
管理者可能收到一份由 AI 生成的员工绩效建议,并需要决定在采取行动之前应审查哪些证据。
招聘人员可能需要审查 AI 生成的候选人名单,并评估其中的建议是否可能包含偏见。
营销人员可能需要评估 AI 生成的市场分析,并识别哪些陈述需要核实来源。
客服人员可能需要判断 AI 生成的回复是否适合直接发送给客户,还是需要人工介入。
这正是交互式学习平台特别有用的地方。评估可以从抽象问题转向现实决策,而不只是检查学习者是否记住了术语。
人工智能素养评估不能只靠选择题
选择题对于基础知识仍然有用,但它们只能是评估的一部分。
更丰富的评估可以结合多种形式。
识别任务
向学习者展示一段 AI 生成的内容,并要求他们识别:
- 缺乏依据的主张;
- 机密信息;
- 可能存在的偏见;
- 具有误导性的确定性表达;
- 经过操纵的视觉内容;
- 需要核实的陈述。
热点标注和视觉识别活动尤其有用,因为它们测试的是一个人能否发现问题,而不仅仅是能否定义问题。
决策情境
人工智能素养往往涉及决策,而不仅仅是非对即错的事实答案。
设想一个 AI 系统根据历史数据建议拒绝一名求职者。
可以向学习者提出:
接下来应该怎么做?
接受该建议?
要求人工复核?
调查底层数据?
寻找潜在偏见?
要求提供更多证据?
分支式情境可以评估学习者如何在具体环境中应用原则。这类体验对于面向 L&D(学习与发展)的 AI 创作工具尤其有用,因为组织可以复现员工实际面对的情境。
比较 AI 输出
学习者可以比较:
- 两个模型;
- 两个提示词;
- 来自不同视角的 AI 生成答案;
- 通用模型的回答与基于可信来源生成的回答。
然后,他们可以识别证据、假设、不确定性、完整性和偏见方面的差异。
信心度检查
信心度为评估增加了另一个维度。
回答正确但信心不足的人可能需要进一步巩固;回答错误却非常自信的人可能带来更大的风险。
这与人工智能素养尤其相关,因为生成式 AI 本身也可能以看似非常自信的方式呈现错误信息。
分类
学习者可以将示例分类为:可靠 / 需要核实 / 不安全
或者:由人类决策 / AI 辅助决策 / 不应由 AI 决策
这可以测试在教育和企业 AI 使用中都很重要的实际区分能力。
AI 辅助评估前后的人工控制
当 AI 参与评估时,人工监督必须从一开始就纳入流程设计,而不能事后补充。
这在受《欧盟人工智能法案》规范的情境中尤其重要。该法规将教育和职业培训中某些用于评估学习成果、决定准入,或对个人教育或职业发展路径产生重大影响的 AI 系统归类为高风险系统。
因此,对于评估流程,一个合理的人工控制模型应设置两个检查点:
评估之前
教师、培训师、教学设计师或经授权的学科专家应验证:
- 学习目标;
- 所评估的能力;
- 评估问题和情境;
- 评分逻辑;
- 任何 AI 生成内容的适当性;
- 所使用的来源;
- 允许 AI 扮演的角色。
AI 可以帮助加快创建过程,但评估什么以及如何评估,应由人类批准。
评估之后
如果 AI 协助进行解释、评分或提出建议,则在结果用于产生重大影响的决策之前,应由具备资质的人员进行审查。
这意味着需要检查:
- 输出是否合理;
- 是否有证据支持;
- 是否可能出现偏见或意外行为;
- 是否需要调查特殊情况;
- 在适当情况下,学习者是否应有复核或申诉的机会。
原则很简单:
事前人工验证 → AI 辅助评估 → 事后人工复核。
需要强调的是,并非所有培训测验或 AI 辅助评估都会根据《欧盟人工智能法案》自动成为高风险系统;其分类取决于目的和使用方式。但即使具体的高风险条款并不适用,人工控制仍是一项稳健的设计原则。
Mexty 如何支持更丰富的人工智能素养评估
Mexty 的
Evaluation(评估)模块旨在将不同评估形式整合到一次可评分的体验中。
评估可以包括:
- 传统测验;
- 热点标注与视觉识别;
- 分支式决策路径;
- 随机题库;
- 信心度检查;
- 分类;
- 比较活动;
- 实践情境。
现有模块还允许围绕明确目标组织评估,而不是创建一个笼统的“AI 测试”。
例如,一个目标可以是:
评估学习者能否识别不可靠的 AI 输出、核实相关证据,并判断何时需要人工介入。
然后,可以围绕这项能力组合相应的活动。
这正体现了 Mexty 更广泛的定位:一个用于创建交互式学习体验的 AI 原生平台。评估与学习体验相连接,而不是作为独立的课程结业测验存在。
对于 L&D
团队,同一环境可以通过连接内容创建、互动活动和评估来简化教学设计工作流程。对于教育领域,它可以支持在课程和学习路径中逐步开展人工智能素养评估。
作为 AI 原生安全学习基础设施,Mexty 旨在同时支持创作者和学习者,并始终将人工验证置于流程核心。
该平台还可以为需要通过现有 LMS 环境交付内容的组织提供兼容 SCORM 的学习体验;同时,Mexty 的 Interactive Course Creator(交互式课程创建器)和评估功能使评估能够超越被动的内容消费。
评估应反映现实世界中的 AI 使用
人工智能素养将在课堂和职场中变得越来越重要。学生需要知道 AI 生成的答案是否可信;员工需要知道 AI 生成的建议是否应该影响客户、招聘、财务或运营决策。此外,管理者还需要理解 AI 可以提供哪些支持,以及哪些责任仍必须由自己承担。
因此,评估的目标不能仅仅是:“这个人是否掌握 AI 词汇?”
它应该转变为:
这个人能理解 AI 吗?
能恰当地使用 AI 吗?
能质疑 AI 吗?
能识别不确定性和偏见吗?
能核实证据吗?
能作出负责任的决定吗?
并且知道何时必须由人类保持控制吗?
这就是从测试 AI 知识转向评估 AI 能力。
如果你喜欢这篇文章,你一定也会喜欢我们接下来的内容。
|